Hai model miễn phí của opencode, và đội agent bảy vai với chi phí 0 đồng
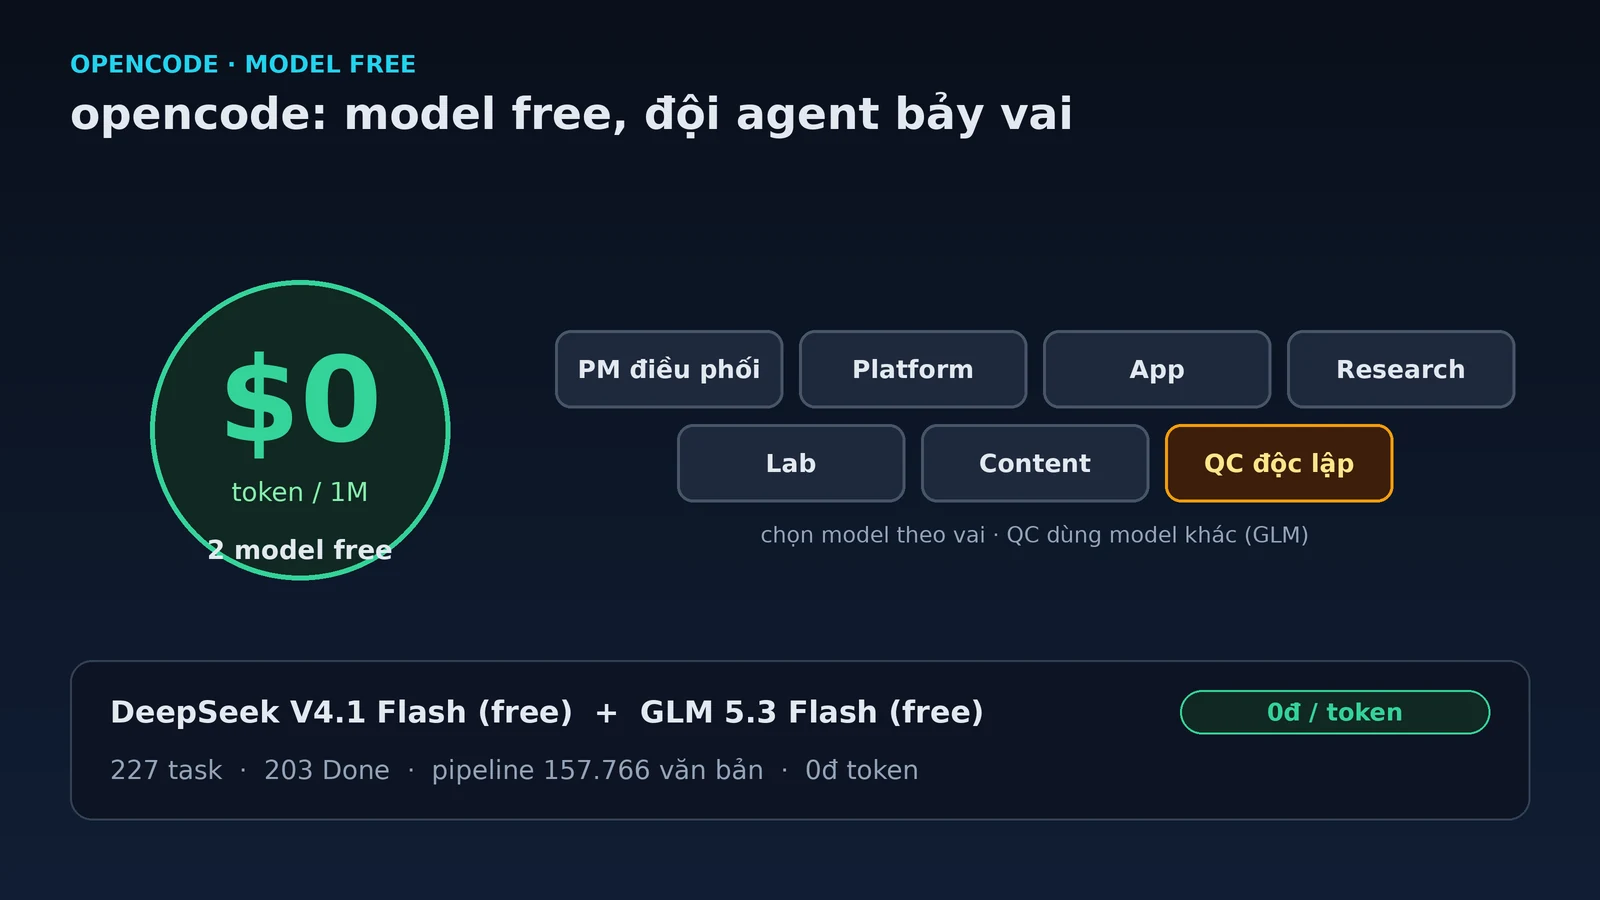
Sáng nay tôi mở lại phần chi phí token của đội agent mình đang chạy. Bảy phiên, gần như chạy liên tục mấy ngày nay. Con số hiện ra là 0 đồng. Cả đội vẫn làm đủ việc, chỉ khác một chỗ: opencode mới cho dùng miễn phí hai model, DeepSeek V4.1 Flash và GLM 5.3 Flash.
Chuyện tiền token vẫn là thứ khiến tôi chùn tay mỗi lần cho agent chạy nền. Một phiên dài ngốn vài đô, nhân lên vài agent là tới cuối tháng nhìn hóa đơn thấy rõ. Nên khi nghe có hai model miễn phí, tôi không chỉ đọc thông báo. Nghe "miễn phí" hơi đáng ngờ, nên tôi mang ra dùng thật.
Bài này có ba phần: bảng giá của opencode, cách tự kiểm hai model miễn phí chỉ với một câu lệnh, và đội bảy vai của tôi đang chạy ra sao.
opencode, nói ngắn gọn
opencode là coding agent chạy được ở CLI, TUI, web và desktop. Nó không tự huấn luyện model. Việc của nó là điều phối: hơn 75 LLM provider, agent và subagent, MCP server, skills, permissions, formatter. Một thứ tôi dùng nhiều là variant, tức chạy cùng model ở mức low, high hoặc max để đổi giữa tốc độ và độ suy nghĩ.
Cách gọi model theo dạng provider_id/model_id, ví dụ opencode/glm-5.3-flash-free. So với Claude Code hay Cursor, opencode mở hơn ở chỗ cho chọn nhiều provider và model.
Cùng một model, nhiều mức giá khác nhau
Xem bảng giá lần đầu, tôi mới để ý cùng một model có thể nằm ở nhiều provider với giá khác nhau. Số liệu lấy từ danh sách model của opencode trên máy tôi, ngày 17/10/2026, đơn vị là USD cho một triệu token.
| Model | Vào | Ra | Biến thể |
|---|---|---|---|
opencode/deepseek-v4.1-flash-free | 0 | 0 | low · high · max |
opencode/glm-5.3-flash-free | 0 | 0 | low · high · max |
opencode/deepseek-v4.1-flash | 0,30 | 1,20 | low · high · max |
opencode-go/deepseek-v4.1-flash | 0,15 | 0,60 | low · high · max |
opencode/glm-5.3-flash | 0,15 | 0,50 | low · high · max |
opencode-go/glm-5.3-flash | 0,15 | 0,50 | low · high · max |
openrouter/z-ai/glm-5.3-flash | 0,0341 | 0,4182 | — |
gói z.ai coding plan | 0 | 0 | theo gói |
Hai dòng đầu là 0/0, tức miễn phí token thật, không phải kiểu giá khuyến mãi. Còn khi phải trả tiền thì nên để ý giá đọc từ cache. Bản opencode-go có giá vào 0,15 nhưng đọc từ cache chỉ 0,003. Agent chạy vòng lặp đọc lại ngữ cảnh rất nhiều, nên phần này chiếm phần lớn hóa đơn cuối cùng.
Hai model miễn phí, kiểm chỉ với một câu lệnh
Hai model miễn phí là DeepSeek V4.1 Flash và GLM 5.3 Flash. Nguồn của thông tin này: thông báo gần đây của opencode, do người dùng chuyển lại. Web search đang lỗi nên tôi không kiểm được trên mạng, thay vào đó tôi kiểm trực tiếp trên máy.
opencode models | grep -E "flash-free"
# opencode/deepseek-v4.1-flash-free
# opencode/glm-5.3-flash-free
CLI liệt kê đúng tên hai model này trong danh sách của opencode. Cách kiểm này tiện hơn vì không phụ thuộc vào một trang thông báo có thể đổi địa chỉ. Cần model suy nghĩ kỹ hơn thì thêm hậu tố biến thể, ví dụ opencode/glm-5.3-flash-free#max.
Đội bảy vai, chi phí 0 đồng
Tôi không để một agent làm hết. Đội của tôi có bảy phiên, mỗi phiên một vai, phối hợp qua một bảng công việc chung. Đây là mô hình "Option B" đang chạy.
                    ┌──────────── Bảng công việc chung ────────────┐
                    │            (task · trạng thái)                │
                    └───────▲───────────────┬───────────────▲──────┘
                            │               │               │
        ┌───────────────────┴──┐   ┌────────┴───────┐  ┌────┴───────────────┐
        │  PM điều phối        │   │  5 vai build   │  │  QC độc lập        │
        │  (loop 15'/1h)       │──▶│  Platform · App│─▶│  verdict PASS/FAIL │
        │  DeepSeek V4.1 Flash │   │  Research · Lab│  │  GLM 5.3 Flash Free│
        └──────────────────────┘   │  Content       │  │  (#max, model khác)│
                                   └────────────────┘  └────────────────────┘
Điều đáng nói là cách chọn model cho từng vai.
| Vai | Model | Việc chính |
|---|---|---|
| PM điều phối | DeepSeek V4.1 Flash | Ưu tiên hóa, giao việc, nghiệm thu; loop 15 phút giờ thấp điểm, 1 giờ giờ cao điểm |
| Platform/Data Engineer | DeepSeek V4.1 Flash | Corpus VBPL, arXiv, Lịch sử; KB; backup và ops |
| Product/App Engineer | DeepSeek V4.1 Flash | KB Chat, UI/UX, wrapper OpenAI-compatible |
| Discovery & Research | DeepSeek V4.1 Flash | Khảo sát nguồn và công nghệ, xác minh đa nguồn, read-only |
| Prototyping Lab | DeepSeek V4.1 Flash | PoC, benchmark, spike |
| Content & Docs | DeepSeek V4.1 Flash | Blog, docs, release notes |
| QC độc lập | GLM 5.3 Flash Free #max | Nghiệm thu độc lập, verdict PASS, PASS-điều kiện hoặc FAIL |
PM và năm vai chạy DeepSeek V4.1 Flash. Riêng QC tôi cố ý cho chạy opencode/glm-5.3-flash-free#max. Lý do khá đơn giản: người chấm mà dùng chung model với người làm thì dễ mắc chung một điểm mù, và cũng dễ tự khen mình.
Sau khoảng hai ngày, bảng có 227 task: 203 Done, 19 Cancelled, 4 còn mở. Vài kết quả cụ thể.
Pipeline citation VBPL xử lý 157.766 văn bản, 106.616 tên file, đối chiếu 88.210 và 73.956 dòng file ở các định dạng pdf, doc, docx, xls, zip, png, tốc độ khoảng 1,4 giây một văn bản. Nó chạy nền dưới systemd và tự chạy tiếp từ chỗ dừng.
Có hôm API gateway của nguồn dữ liệu sập, trả 503 liên tục trong khoảng 16,5 giờ. Job vẫn sống. Nó chờ và thử lại 10 phút một lần, tới khi nguồn hoạt động trở lại thì chạy tiếp, không mất một dòng dữ liệu nào. Vai QC tự phát hiện outage và chờ hồi phục, thay vì báo lỗi giả.
QC chấm mỗi task một verdict, tái lập số liệu bằng truy vấn chỉ đọc, kiểm URL bằng lệnh HEAD, và mở trình duyệt thật để xem giao diện. Hai task được PASS vì số liệu khớp chính xác từng con, kết luận là lỗi nằm ở nguồn chứ pipeline không đánh rơi dữ liệu.
Tổng tiền token cho cả đội là 0 đồng, vì PM và năm vai chạy bản free, QC chạy một bản free khác. Hạ tầng là máy local: SQLite cho corpus, UI chat chạy local, GPU RTX 2060. Tiền thật chỉ còn điện và Internet.
Vài thứ tôi rút ra
Chọn model theo vai. Đọc tài liệu, tổng hợp, hoặc chạy các vòng kiểm tra thì model Flash là đủ; chỉ việc khó mới cần tới mức max.
QC nên dùng model khác với người làm. Chuyện này tôi đã nói ở trên nhưng đáng nhắc lại, vì nó là thứ dễ bỏ qua nhất khi dựng đội.
Về chi phí, số lần gọi và kích thước ngữ cảnh vẫn quyết định nhiều hơn giá mỗi token. Việc cơ học như crawl, làm sạch, backup thì chạy bằng script, không cần gọi model. Việc nặng nên dồn vào giờ thấp điểm. Tôi kể kỹ chuyện này trong bài trước về loop engineering.
Về độ bền, job dài kiểu gì cũng gặp mạng chập, API 503, tiến trình chết. Job cần chạy lại được từ chỗ dừng và không sinh dữ liệu trùng. Sự cố 16,5 giờ đó không mất một dòng nào, phần lớn là nhờ thiết kế, không phải may.
Phần chưa tốt. Model miễn phí vẫn kém hơn bản trả phí: có thể bị giới hạn tốc độ, độ trễ không đều, có lúc chậm hơn hẳn. Nó phù hợp để thử nghiệm, học, và với những đội nhỏ làm khối lượng vừa phải. Việc quan trọng hoặc cần ổn định thì nên trả tiền. Nhưng 0 đồng cũng không hẳn là miễn phí: tôi vẫn trả bằng điện, Internet, phần cứng và thời gian vận hành. Số 227 task ở trên là của một máy local, nên đọc như kinh nghiệm của tôi, đừng coi là bảng xếp hạng.
Kết
Điều giữ cho đội chạy được không phải giá model, mà là cách chia vai và thiết kế để chạy bền. Hai model miễn phí chỉ làm việc bắt đầu dễ hơn. Muốn thử thì một lệnh là đủ: opencode models | grep flash-free.
Tài liệu tham khảo
- opencode — Models — hơn 75 provider, variant
low/high/max, cấu hình model và cách chọn. - opencode v2 — phiên bản v2.
opencode models— CLI liệt kê model trên máy; xác nhậnopencode/deepseek-v4.1-flash-freevàopencode/glm-5.3-flash-free(kiểm ngày 17/10/2026).- Loop engineering: vận hành một đội agent làm hơn 100 việc — bài trước về thiết kế vòng lặp và chi phí token.
Giá trong bài là giá ngày 17/10/2026 và có thể thay đổi. Hai model free được ghi theo thông báo gần đây của opencode do người dùng cung cấp, và tôi xác nhận lại bằng CLI trên máy.