Loop engineering: vận hành một đội agent làm hơn 100 việc
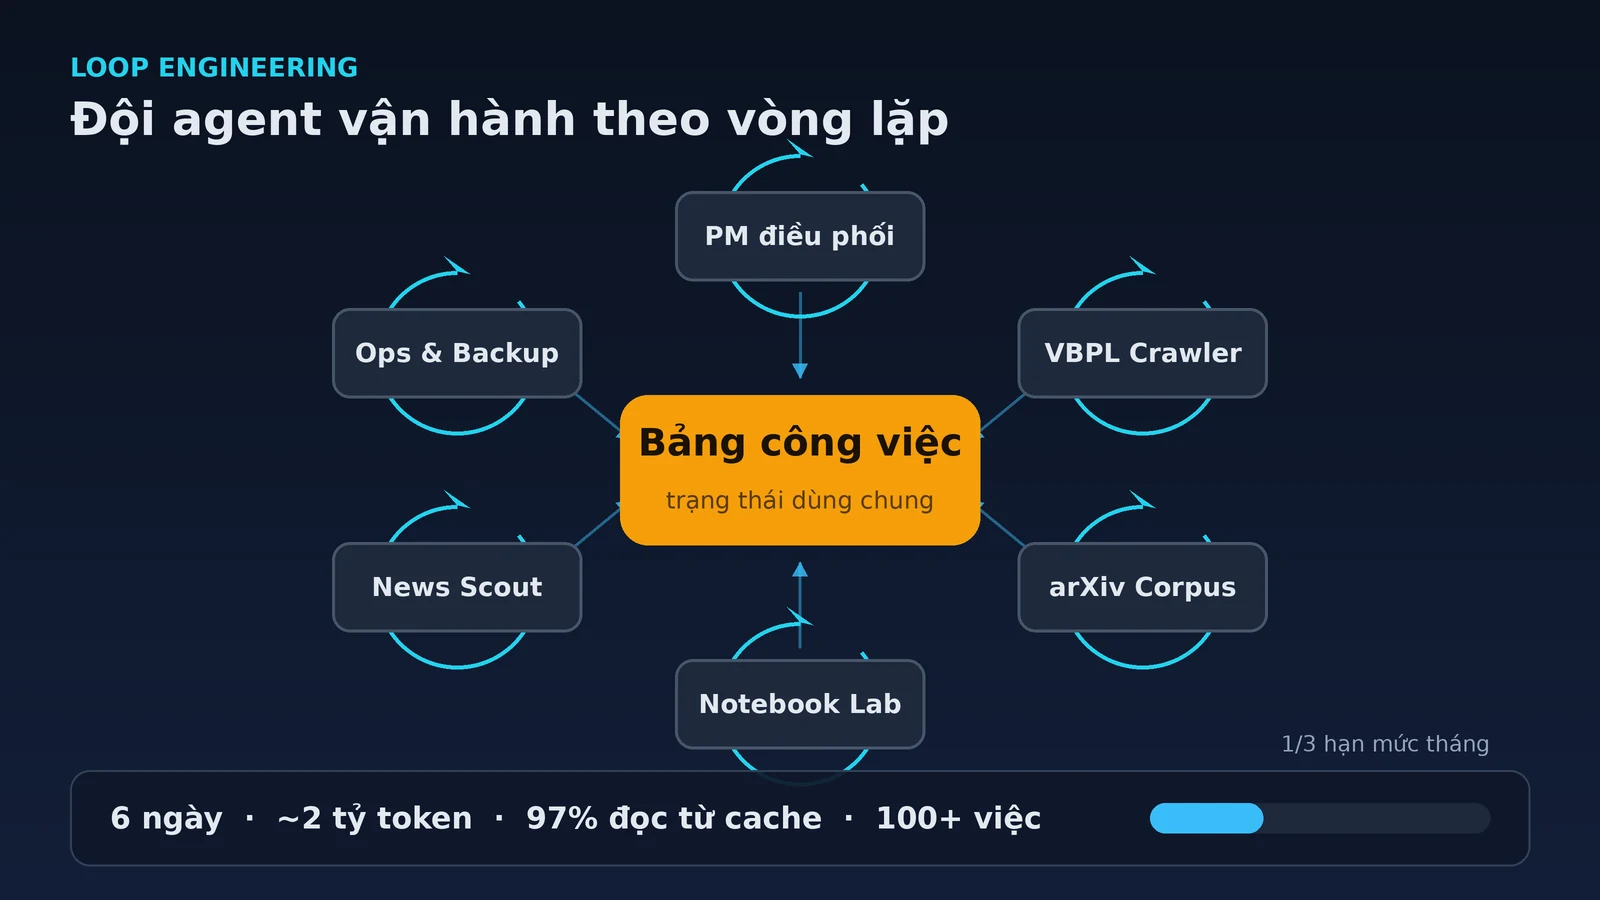
Sáu ngày vừa rồi, một đội agent của tôi làm xong hơn 100 việc: thu thập và kiểm tra toàn vẹn 156.404 văn bản pháp luật, làm sạch metadata cho 3,19 triệu bài báo khoa học, dựng một kho tri thức ba tầng có vector, và sao lưu 26 GB mỗi ngày. Tôi làm việc này trong một gói thuê bao khoảng 10 đô một tháng. Trong sáu ngày đó, hệ thống dùng khoảng 2 tỷ token, và 97% là đọc lại từ cache.
Nhưng mấy con số đó chưa phải phần khó. Cái khó là giữ cho nhiều agent chạy đều, tốn ít, không kẹt, và biết dừng đúng lúc.
Kỹ thuật viết prompt (prompt engineering) chỉ giải quyết một lần gọi model. Loop engineering giải quyết cả vòng vận hành: cái gì chạy, bao lâu chạy một lần, mỗi vòng tốn bao nhiêu token, và khi nào thì dừng. Bài này kể lại cấu trúc đội agent của tôi, cách tôi thiết kế từng vòng lặp, số liệu thật, kể cả phần chưa tốt — vì đó mới là phần đáng nói.
1. Đội agent của tôi chạy thế nào
Trước hết cần nói rõ: đây không phải chuyện tôi ngồi chat với nhiều agent cùng lúc. Đây là một tổ chức nhỏ, có phân vai, có bảng công việc, và có quy trình bàn giao.
Tôi dùng nhiều phiên (session) chuyên trách trên opencode, mỗi phiên lo một việc:
| Agent | Việc phụ trách | Kết quả chính |
|---|---|---|
| Product Manager | Điều phối, sắp thứ tự ưu tiên, nghiệm thu | Việc được giao và đóng lại |
| VBPL Crawler | Thu thập, kiểm tra, xử lý văn bản pháp luật | 156.404 văn bản và tệp kết quả |
| arXiv Corpus | Thu thập và làm sạch metadata học thuật | 3,19 triệu bài báo |
| Notebook Lab | Thử nghiệm, dựng bản thử, đo đạc | Notebook và báo cáo kỹ thuật |
| News Scout | Theo dõi tin tức AI, kiểm chứng nhiều nguồn | Bản tin có dẫn nguồn |
| Ops / Backup | Hạ tầng, sao lưu, xử lý sự cố | Sao lưu 26 GB mỗi ngày |
Thứ giữ đội này lại không phải một framework điều phối nào cả, mà là một bảng công việc chung (Notion) làm nơi làm việc giữa tôi và các agent. Tôi và agent cùng đọc, cùng ghi trên đó. Nghe đơn giản, nhưng gần như mọi phần sau của bài đều xoay quanh cái bảng này.
2. Loop engineering: thiết kế vòng lặp, không phải viết prompt cho hay
Anthropic định nghĩa agent rất ngắn: một model tự dùng công cụ trong một vòng lặp. Nhưng vòng lặp đó không tự nhiên mà đúng; nó phải được thiết kế.
Nền tảng thì đã có từ lâu. ReAct cho model xen kẽ suy luận và hành động; Reflexion cho agent tự nhìn lại sau mỗi lần thất bại. Nhưng khi đem ra vận hành thật, câu hỏi không còn là "agent có biết nhìn lại hay không", mà là mỗi lần nhìn lại tốn bao nhiêu và bao lâu làm một lần.
Trong hệ thống của tôi, loop engineering là một tập hợp các vòng lặp cụ thể. Mỗi vòng có nhịp chạy, việc phải làm, và điều kiện dừng rõ ràng:
| Vòng lặp | Nhịp chạy | Việc làm | Có gọi model? |
|---|---|---|---|
| Vòng PM | 15 phút (giờ thấp điểm), 1 giờ (giờ cao điểm) | Quét việc cần làm, đánh giá rủi ro, giao việc | Có |
| Watchdog | 5 phút | Kiểm tra tiến trình nền, khởi động lại khi chết | Không |
| Đọc comment | mỗi vòng PM | Xem comment mới trên việc đang mở | Có, khi có việc |
| Bắt việc mồ côi | mỗi vòng PM | Tìm việc bị bỏ quên | Không |
| Sao lưu | 03:00 mỗi ngày | Đẩy 26 GB lên cloud | Không |
| Kiểm tra sau khi giao | sau mỗi lần giao việc | Xác nhận job thật sự còn sống | Không |
Có hai quyết định thiết kế quan trọng.
Một là, việc cơ học thì không gọi model. Thu thập dữ liệu, làm sạch, tạo embedding, sao lưu, kiểm tra tiến trình đều là script Python hoặc bash, tốn 0 token. Chỉ những việc cần phán đoán — đánh giá rủi ro, viết, tổng hợp — mới cần đến model. Đây là lý do một đội agent chạy suốt ngày mà hóa đơn vẫn nhỏ.
Hai là, mỗi vòng phải có nhịp chạy tính theo giá. Nhà cung cấp tính giá giờ cao điểm cao gấp đôi ngoài giờ. Vòng kiểm tra nhẹ thì chạy dày, 15 phút một lần. Việc nặng như tạo embedding hay thu thập dữ liệu lớn thì dồn vào giờ thấp điểm (17:00–08:00 và cuối tuần). Quy tắc "ưu tiên giờ thấp điểm" này về sau thành một đề xuất chính thức trong bản đánh giá nội bộ.
3. Bảng công việc là bộ nhớ, không phải lịch sử chat
Một lỗi thường gặp khi dựng đội agent là để mỗi phiên tự nhớ mọi thứ trong ngữ cảnh. Cách đó sập rất nhanh.
Anthropic gọi hiện tượng này là context rot: càng nhiều token trong ngữ cảnh, model càng khó nhớ chính xác, kể cả những model tốt nhất. Nghiên cứu Context Rot của Chroma cho thấy model xử lý ngữ cảnh không đều chút nào. Ngữ cảnh càng dài thì càng kém ổn định, ngay cả với việc đơn giản.
Nên tôi kéo trạng thái ra khỏi ngữ cảnh, để trên bảng và trong file:
- Bảng công việc giữ trạng thái từng việc:
Ready,In Progress,Review,Blocked,Done. dispatch-log.mdghi lại mọi lần giao việc và nghiệm thu.comments-seen.jsonnhớ comment nào đã xử lý, để không trả lời trùng.jobs.jsonlà danh sách các job nền đang chạy.
Mỗi vòng đọc bảng, quyết định, ghi lại rồi thoát. Phiên không cần nhớ lịch sử dài. Cách làm này khớp với ba kỹ thuật Anthropic khuyên dùng cho agent chạy lâu: nén ngữ cảnh khi gần đầy, ghi chú ra bộ nhớ ngoài, và tách agent con — mỗi agent con có ngữ cảnh sạch và chỉ trả về bản tóm tắt ngắn.
        ┌────────────── Bảng công việc ──────────────┐
        │  Ready → In Progress → Review → Done        │
        └───────▲──────────────────────────┬──────────┘
                │                          │ đọc
          ghi trạng thái                   ▼
        ┌───────┴──────┐          ┌─────────────────┐
        │  Vòng PM     │─────────▶│  Agent thực thi │
        │  (điều phối) │ giao việc│  (VBPL/arXiv…)  │
        └──────────────┘          └─────────────────┘
4. Kinh tế token: cache là nhân vật chính
2 tỷ token trong sáu ngày nghe rất nhiều, nhưng 97% trong đó là đọc lại từ cache. Phần đã gửi trước đó được dùng lại thay vì tính như token mới.
DeepSeek mô tả cơ chế context caching như sau: nếu request sau có phần đầu trùng với request trước, phần trùng đó chỉ được đọc từ cache, gọi là trúng cache. Với mức giá tôi đang dùng, đọc từ cache rẻ hơn khoảng 50 lần so với token đầu vào thường. Nhờ vậy một vòng PM đọc lại 60–200K token ngữ cảnh mà chỉ tốn vài phần nghìn đô.
Điều này dẫn tới một kết luận tôi phải mất một thời gian mới thấy. Chi phí tỉ lệ với số lần gọi nhân với kích thước ngữ cảnh, chứ không phụ thuộc vào model đắt hay rẻ. Tôi từng nghĩ dùng model rẻ hơn cho vòng kiểm tra sẽ tiết kiệm. Sai. Thứ quyết định là ngữ cảnh phình bao nhiêu và gọi bao nhiêu lần.
Số liệu thật trong 4,4 ngày (30/09–04/10), quy đổi theo giá API lẻ và tính cả giờ cao điểm:
| Phiên | Token đầu vào | Đọc từ cache | Chi phí tương đương |
|---|---|---|---|
| VBPL Crawler | 11,18M | 666,9M | ~$5,63 |
| Vòng PM | 11,06M | 318,3M | ~$3,69 |
| Main (người dùng) | 8,74M | 278,5M | ~$2,89 |
| Notebook Lab | 5,63M | 294,5M | ~$2,29 |
| arXiv Corpus | 4,20M | 107,1M | ~$1,20 |
| News Scout | 0,96M | 13,1M | ~$0,24 |
Vì sao cần để ý: Anthropic đo được agent thường dùng token gấp khoảng 4 lần so với chat thường, còn hệ nhiều agent thì gấp khoảng 15 lần. Nhiều agent không hề miễn phí. Đó là cách tiêu token để mua thêm năng lực, nên chỉ nên dùng khi việc đủ giá trị và ta kiểm soát được mỗi vòng tốn bao nhiêu.
5. Vòng nào đáng tiền, vòng nào đốt tiền
Phần này tôi muốn nói thẳng.
Trong 4,4 ngày đó, vòng PM chạy 324 lần và khoảng 56% là không làm gì cả. Riêng phần này tốn khoảng 10–13 đô một tháng theo giá API, tức khoảng 23% tổng chi phí. Nói cách khác, gần một phần tư công suất chỉ để chạy đi kiểm tra xem có gì mới không, rồi kết luận là không có gì.
Ba điểm nghẽn lớn nhất lộ ra:
- Chờ tôi duyệt. Có việc chờ tôi duyệt rủi ro tới 30 giờ, một việc khác 10,8 giờ, một việc treo hơn 33 giờ. Agent rảnh 85–99% thời gian. Nút thắt thật không nằm ở năng lực của agent, mà ở khâu tôi phải duyệt.
- Vòng PM và ngữ cảnh phình to. Một vòng không làm gì chỉ tốn khoảng 0,006 đô, nhưng ngữ cảnh mỗi vòng phình lên 60–200K token. Phiên PM bị nén và xoá lịch sử 16 lần trong khoảng thời gian đo, gây mất ngữ cảnh và có nguy cơ bỏ sót việc.
- Giám sát job nền còn bị động. Có 58 lần watchdog phải khởi động lại một job, có đợt dồn tới 17 lần trong 1,5 giờ. Một job chết im lặng cho tới khi tôi tự phát hiện.
Điểm chung của cả ba: tôi chăm chút phần thú vị như model và prompt, mà quên phần tẻ nhạt nhưng quan trọng là nhịp chạy, điều kiện dừng, và giám sát.
6. Ba thứ đã sửa, ba thứ còn mở
Bản đánh giá nội bộ đưa ra 6 đề xuất. Tôi chọn làm trước 3 cái không ảnh hưởng chất lượng.
Đã sửa:
- Quét việc mồ côi. Tôi viết
check-stalled.py: một việc đangIn Progressmà tiến trình không còn sống, log cũ quá 2 giờ, và không nằm trong danh sách miễn trừ thì bị gắn cờ. Nó bắt đúng lỗ hổng V70 — việc bị đánh dấu là đang chạy nhưng không ai giao, trễ 10,8 giờ. Script có đối chiếu với danh sách job nền nên không gắn cờ oan. - Ưu tiên giờ thấp điểm. Đưa thành quy tắc khi giao việc: việc nặng nên đẩy vào 17:00–08:00 và cuối tuần. Không đổi lịch chạy, chỉ đổi thứ tự ưu tiên.
- Bộ giám sát có khoảng lùi. Thay vì khởi động lại cứng mỗi 5 phút, bộ giám sát thử lại với khoảng lùi tăng dần 5'→10'→20'→30', và cảnh báo khi hết lượt. Hết cảnh dồn dập.
Còn mở, tôi chưa làm:
- Chốt kiểm tra trước khi gọi model. Đây là việc tiết kiệm lớn nhất: cho một script chạy mỗi 15 phút để kiểm tra bảng, comment, tiến trình; chỉ gọi model khi thật sự có việc mới. Nó xử lý trực tiếp 56% vòng rỗng, nhưng đụng vào logic điều phối nên tôi để sau.
- Tách phiên VBPL. Một phiên chạy liên tục từ tháng 7 tích lũy ngữ cảnh tới 432K token mỗi message, khoản đọc cache đắt nhất hệ thống. Cần tách phần thu thập dữ liệu khỏi phần nghiên cứu kho tri thức, kèm một bản bàn giao.
- Giảm ngữ cảnh phiên PM. Hạ ngưỡng nén và chuyển bớt trạng thái quan trọng ra file.
Tôi cố tình không làm cả 6 cùng lúc. Mỗi thay đổi trong vòng điều phối đều có thể kéo theo thứ khác, nên tôi muốn thử từng cái một.
7. Vài điều rút ra
Vòng lặp phải rẻ trước khi thông minh. Một vòng chạy 15 phút một lần mà mỗi lần ngốn vài trăm nghìn token sẽ âm thầm ăn hết ngân sách. Tối ưu nhịp chạy và ngữ cảnh trước, thêm năng lực sau.
Nút thắt thường là con người, không phải model. 30 giờ chờ duyệt lớn hơn mọi độ trễ kỹ thuật trong hệ thống. Tự động hóa vòng lặp mà không tự động hóa khâu duyệt thì chỉ dời hàng đợi sang chỗ khác.
Quan sát được trước đã, rồi hãy cho tự chủ. Không theo dõi được từng bước truy xuất, xếp hạng và quyết định của agent thì không sửa được gì. Tôi phải dựng log và danh sách job trước khi dám cho agent chạy nền.
Nhiều agent không miễn phí. Tốn gấp khoảng 15 lần so với chat. Nó hợp với việc song song được và đáng giá, nhưng không hợp với việc ràng buộc chặt và ít song song. Anthropic cũng cảnh báo điều này.
Bảng công việc là hạ tầng, không phải thứ phụ. Một bảng chung làm bộ nhớ ngoài cho cả người và agent rẻ hơn, bền hơn và minh bạch hơn mọi cơ chế để AI tự nhớ.
Kết
Tôi không nghĩ mình đang thay người bằng AI. Tôi đang chạy một cách làm đơn giản hơn: một người, một quy trình tốt, và một đội agent. Hơn 100 việc trong sáu ngày không đến từ model thông minh hơn, mà từ việc thiết kế vòng lặp đủ rẻ và đủ rõ để chạy mà không cần tôi ngồi cạnh.
Việc tiếp theo khá rõ: dựng bước kiểm tra trước vòng PM, để những vòng chỉ đi hỏi "có gì mới không" ngừng đốt token. Đó là cách trực tiếp nhất để cắt 56% vòng rỗng.
Tài liệu tham khảo
- Building effective agents — Anthropic, 12/2024; phân biệt workflow và agent, cùng các pattern orchestrator-workers và evaluator-optimizer.
- How we built our multi-agent research system — Anthropic, 06/2025; số liệu agent dùng ~4× token và hệ nhiều agent dùng ~15× token so với chat.
- Effective context engineering for AI agents — Anthropic, 09/2025; nén ngữ cảnh, ghi chú có cấu trúc, tách agent con.
- Context Rot: How Increasing Input Tokens Impacts LLM Performance — Chroma, 07/2025.
- ReAct: Synergizing Reasoning and Acting in Language Models — Yao và cộng sự, 2022.
- Reflexion: Language Agents with Verbal Reinforcement Learning — Shinn và cộng sự, 2023.
- Context Caching — DeepSeek API Docs.
- Measuring AI Ability to Complete Long Software Tasks — METR, 2025; nền tảng cho phần bàn về độ dài công việc mà agent có thể tự hoàn thành.
Số liệu vận hành lấy từ bản đánh giá nội bộ ngày 04/10/2026. Nguồn tham khảo ngoài được kiểm tra ngày 05/10/2026.